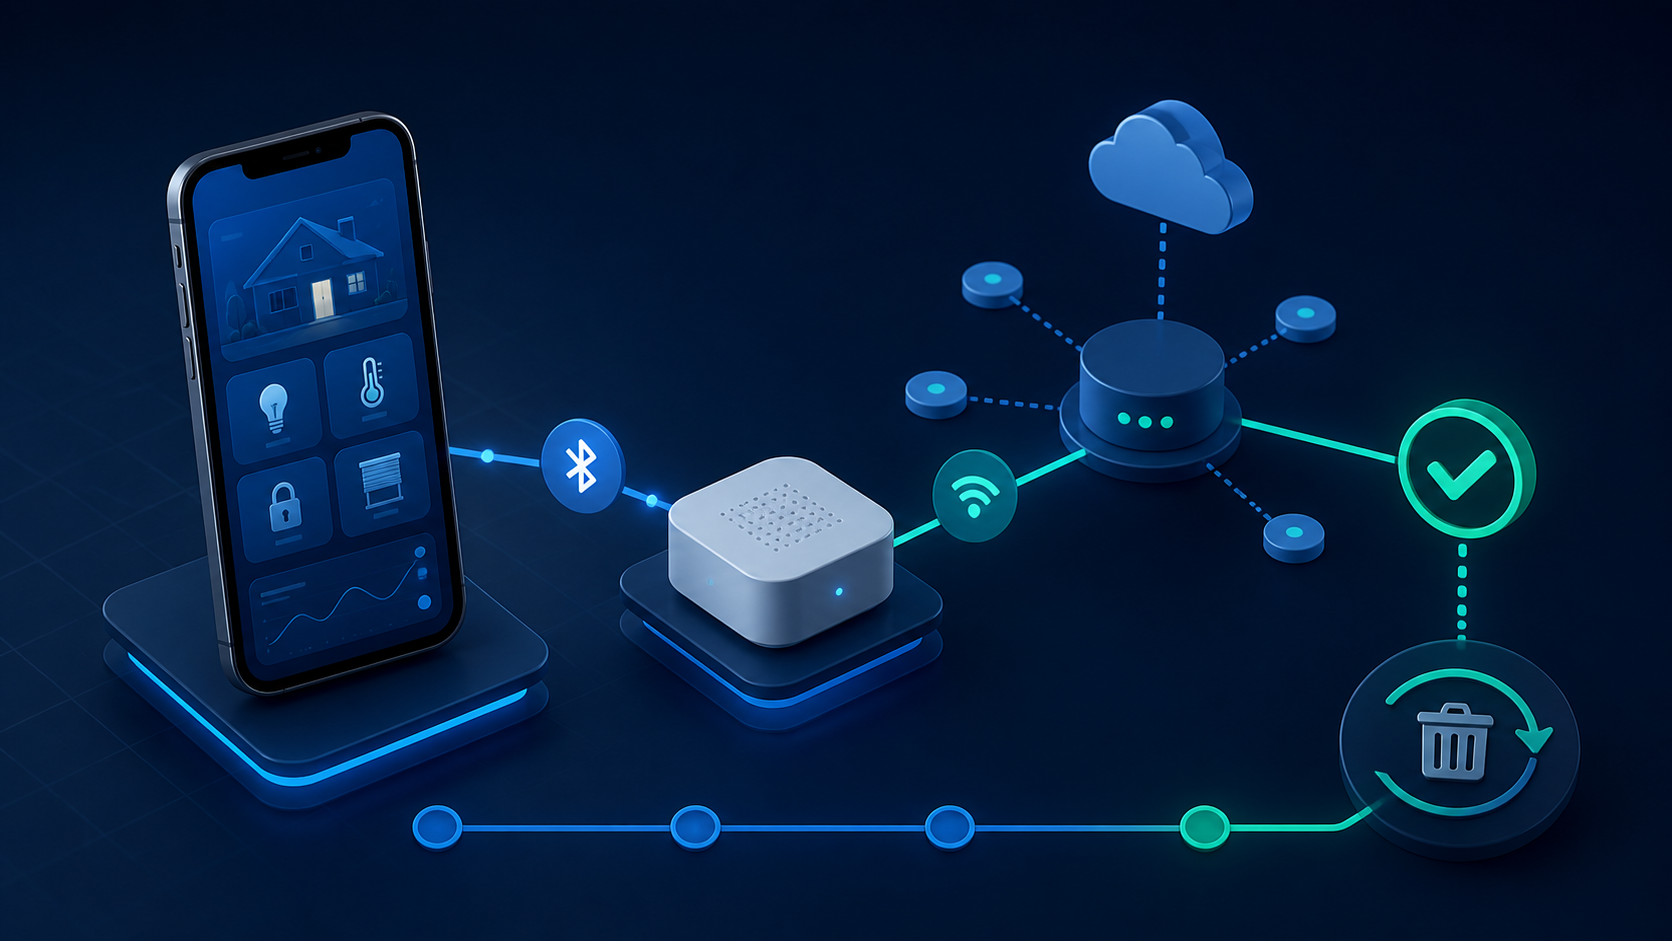
Flutter integration_test에서 테스트가 끝났다고 연결도 끝난 것은 아니다. MQTT Stream, BLE 스캔 구독, GetX Controller가 살아 있으면 다음 테스트에 이전 이벤트가 섞인다. 이번에는 tearDown에서 리소스를 닫고, 앱 프로세스가 내려갈 때도 한 번 더 정리하는 구조로 flaky 테스트를 줄였다.
실패는 두 번째 테스트에서 터졌다
처음에는 각 테스트 시작 시 Fake 데이터를 초기화하면 충분하다고 생각했다. 실제로는 첫 번째 케이스가 남긴 MQTT 메시지가 두 번째 케이스의 expect보다 먼저 들어왔다. BLE도 마찬가지였다. 스캔 Stream을 cancel하지 않아서 테스트가 끝난 뒤에도 발견 이벤트가 출력됐다.
특히 CI에서는 테스트 파일을 단독 실행할 때는 통과하고, 여러 테스트를 한 번에 실행할 때만 실패했다.
| 남은 리소스 | 겉으로 보이는 증상 | 정리 위치 |
|---|---|---|
| MQTT subscription | 이전 ACK가 다음 테스트에 반영됨 | Repository close() |
| BLE scan Stream | 테스트 종료 후 발견 로그 출력 | Fake/Wrapper dispose() |
| GetX Controller | 이전 기기 상태가 재사용됨 | Get.reset() |
| Timer·Retry 작업 | 종료 뒤 재연결 시도 | Controller onClose() |
그림에서 볼 부분은 테스트 성공 표시 뒤에도 MQTT·BLE 선을 끊고 정리 단계로 들어가는 흐름이다. 성공 여부와 자원 해제는 별개의 단계다.
테스트마다 소유한 리소스를 닫는다
테스트 코드가 직접 패키지 객체를 만지면 누가 닫아야 하는지 모호해진다. 그래서 실제 앱과 동일하게 MqttService, BleService를 주입하고, 테스트가 만든 객체의 수명도 테스트가 책임지게 했다.
아래처럼 tearDown을 공통으로 두면 테스트가 실패해도 정리 코드가 실행된다.
import 'package:flutter_test/flutter_test.dart';
import 'package:integration_test/integration_test.dart';
import 'package:get/get.dart';

void main() {
  IntegrationTestWidgetsFlutterBinding.ensureInitialized();

  late FakeMqttService mqtt;
  late FakeBleService ble;

  setUp(() {
    mqtt = FakeMqttService();
    ble = FakeBleService();
    Get.put<MqttService>(mqtt);
    Get.put<BleService>(ble);
  });

  tearDown(() async {
    // Controller가 잡고 있는 Timer와 Stream부터 해제
    await Get.reset();
    await ble.dispose();
    await mqtt.disconnect();
  });

  testWidgets('기기 상태를 조회하고 연결을 닫는다', (tester) async {
    await tester.pumpWidget(const TestApp());
    await tester.tap(find.text('상태 조회'));
    await tester.pumpAndSettle();

    expect(find.text('정상'), findsOneWidget);
  });
}
순서도 신경 써야 한다. Controller가 아직 Stream을 구독한 상태에서 서비스부터 닫으면 비동기 콜백이 닫힌 객체를 다시 건드릴 수 있다. 그래서 Get.reset()으로 구독자와 Timer를 먼저 없앤 뒤 BLE와 MQTT 클라이언트를 닫았다.
앱 종료 훅은 마지막 안전망이다
tearDown은 테스트 함수 단위 정리다. 앱이 강제 종료되거나 테스트 러너가 중간에 앱을 재시작하는 경우까지 보장하지는 않는다. 서비스 레이어에도 멱등적인 close()를 둬야 한다.
class MqttService {
  StreamSubscription? _messageSub;
  bool _closed = false;

  Future<void> disconnect() async {
    if (_closed) return;
    _closed = true;
    await _messageSub?.cancel();
    _messageSub = null;
    await client.disconnect();
  }
}

class DeviceController extends GetxController {
  Timer? _retryTimer;
  StreamSubscription? _statusSub;

  @override
  void onClose() {
    _retryTimer?.cancel();
    _statusSub?.cancel();
    _retryTimer = null;
    _statusSub = null;
    super.onClose();
  }
}
disconnect()를 두 번 호출해도 안전해야 한다. 테스트 종료와 앱 생명주기 종료가 동시에 들어오는 경우가 있기 때문이다. 이 부분을 빼먹었을 때 CI 로그에는 StateError: Cannot add new events after calling close가 간헐적으로 남았다.
CI에서는 종료 로그를 남긴다
정리 여부는 눈으로 확인하기 어렵다. 각 Fake 서비스에 isDisposed와 연결 해제 횟수를 기록하면 실패 원인을 빠르게 좁힐 수 있다.
expect(mqtt.disconnectCount, 1);
expect(ble.disposeCount, 1);
expect(Get.isRegistered<MqttService>(), isFalse);
다만 실제 MQTT 브로커와 BLE 실기기를 붙인 테스트에서는 강제 disconnect를 성공 조건으로 삼지 않았다. 네트워크가 끊긴 상황에서 disconnect 자체가 지연될 수 있어서, 테스트에서는 timeout을 두고 로컬 Stream과 Timer가 먼저 닫혔는지를 검증했다. FOTA 재개처럼 앱을 다시 띄우는 흐름도 이 정리 규칙이 있어야 이전 연결의 진행률 이벤트가 섞이지 않는다.
정리하면 다음 기준이다.
- 테스트가 만든 서비스는
tearDown에서 닫는다. - Controller의 Stream, Timer를 서비스보다 먼저 해제한다.
disconnect()와dispose()는 여러 번 호출해도 안전하게 만든다.- CI에서 해제 횟수와 등록된 의존성 상태를 검증한다.
테스트가 가끔 실패하는 문제를 타이밍 탓으로만 돌리기 쉽다. IoT 앱에서는 종료되지 않은 연결 하나가 다음 테스트의 입력이 된다. 테스트 시작 코드보다 종료 코드를 먼저 점검하는 편이 훨씬 빨리 원인을 찾는다.